Databases en warehouses
Er zijn starters voor onder andere PostgreSQL, MySQL/MariaDB, Microsoft SQL Server, ClickHouse, BigQuery, Snowflake, Amazon RDS, Redshift, Oracle, MongoDB, Elasticsearch/OpenSearch, Redis, Databricks, Trino/Presto en DuckDB.
Execution engine
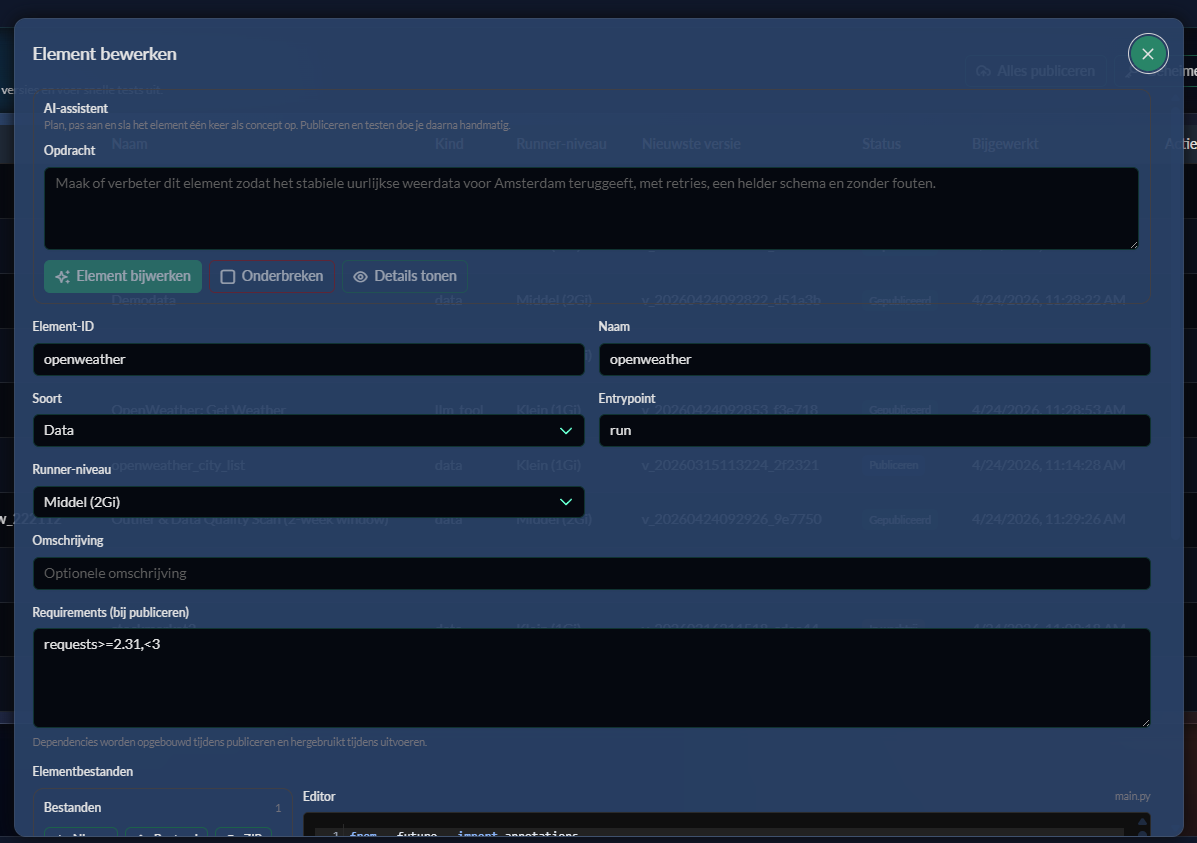
Elements zijn Python bouwblokken binnen Dashview. Deze hub splitst de documentatie in twee detailreferenties: editor/filebeheer en runtime/execution.
logger.info(...), logger.error(...) en logger.exception(...) gebruiken om diagnostische meldingen aan die logs toe te voegen.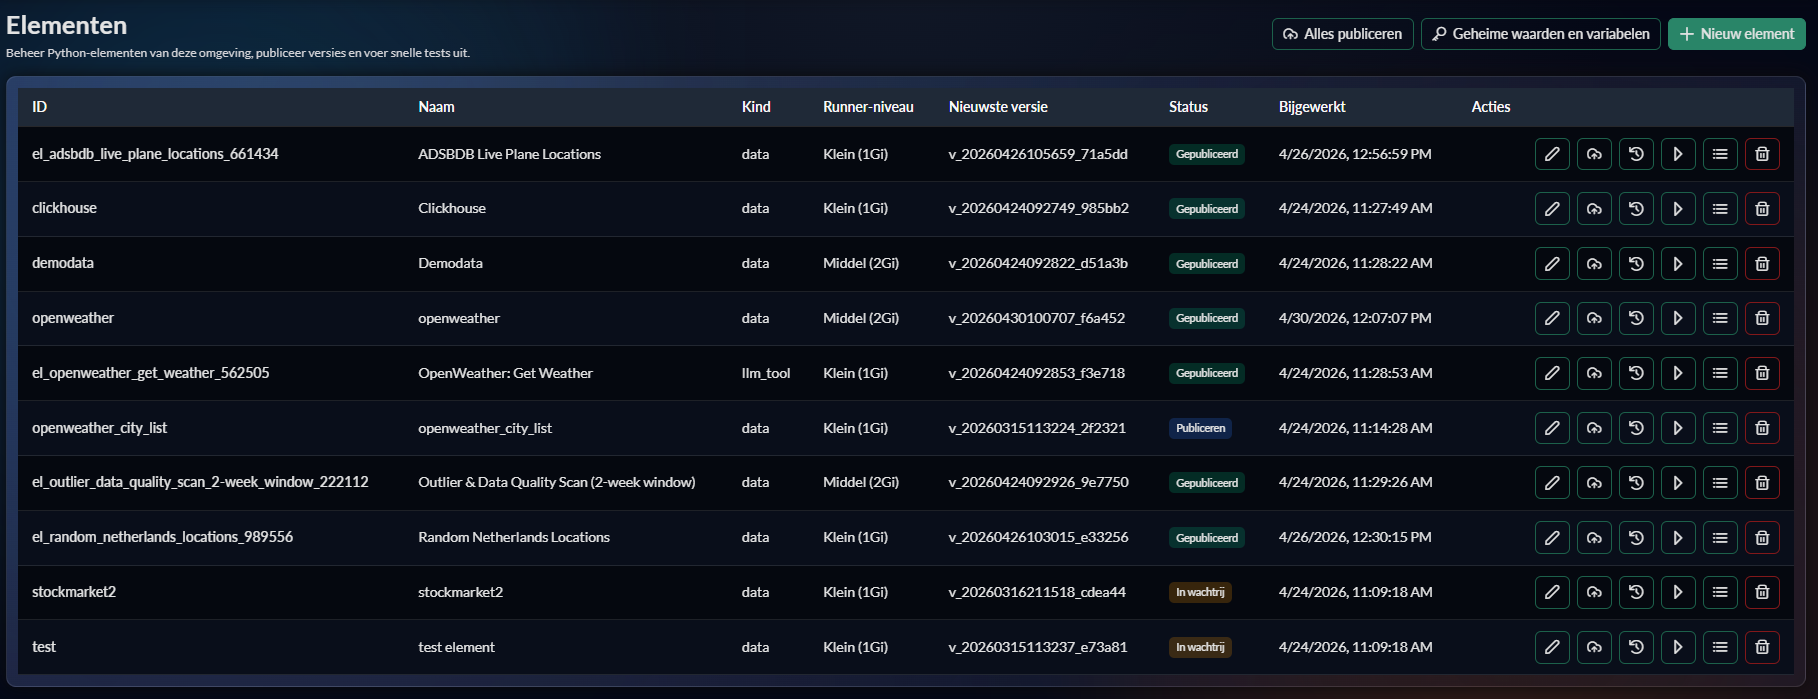
Open Element-marktplaats in Administration → Elements om een bewerkbaar Element-draft te starten vanuit de platformcatalogus in Firestore, die aanvankelijk met 86 voorbeelden wordt gevuld. Zoek op provider of gebruikssituatie en filter op categorie en Elementsoort.
De catalogus wordt uit Firestore geladen wanneer je de marktplaats opent. Platformbeheerders kunnen daardoor templates bewerken of toevoegen zonder de frontend opnieuw te bouwen. Providerlogo's worden als gesaniteerde SVG-afbeeldingen bij iedere template opgeslagen. De gedeelde catalogus verandert de tenantisolatie niet: een keuze maakt alleen een niet-opgeslagen draft binnen je huidige tenant.
Klik op Template gebruiken om de configuratiewizard te openen. De wizard controleert bestaande tenantbrede runtimevariabelen en secrets en toont velden die passen bij de connector: databasehost, poort en inloggegevens; API-URL's en authenticatie; cloudresources of bestandspaden. Tekst voer je normaal in, zonder JSON-aanhalingstekens. Verbindingsobjecten worden automatisch samengesteld. Voor Google-serviceaccounts kun je een JSON-sleutelbestand importeren of de sleutel plakken; de sleutel blijft write-only. Geavanceerde zoekqueries gebruiken nog wel JSON. Bestaande secrets blijven behouden, tenzij je expliciet Verbinding vervangen kiest en de volledige vervangende configuratie invoert. Na het controleren slaat Dashview de configuratie op en opent een nieuw Element-concept. Met Terug naar de marktplaats ga je vanuit beide stappen terug naar het overzicht. Zoekterm en filters blijven behouden; niet-opgeslagen invoer wordt verwijderd.
Verplichte velden, poorten, URL's en serviceaccountbestanden worden voor het opslaan gevalideerd. Kafka toont authenticatievelden voor het gekozen beveiligingsprotocol; SFTP vraagt om de geverifieerde hostsleutel. Bestandspaden verwijzen naar bestanden die al beschikbaar zijn in de Element-runtime en uploaden geen bestanden. Eigen runtimesleutels zonder ingebouwd formulier behouden de generieke JSON/tekst-editor. De wizard test de externe verbinding niet: controleer de code, vervang waar nodig voorbeeldtabellen of requestlogica en sla het Element daarna op, publiceer en test het.
Er zijn starters voor onder andere PostgreSQL, MySQL/MariaDB, Microsoft SQL Server, ClickHouse, BigQuery, Snowflake, Amazon RDS, Redshift, Oracle, MongoDB, Elasticsearch/OpenSearch, Redis, Databricks, Trino/Presto en DuckDB.
Kant-en-klare integraties omvatten Salesforce, HubSpot, Stripe, Shopify, Dynamics 365 / Dataverse, ServiceNow, Jira, Confluence, GitHub, GitLab, Google Sheets, Excel / OneDrive, SharePoint en SFTP.
Start met Kafka / Confluent, Google Pub/Sub, Amazon Kinesis, Azure Event Hubs, Prometheus, Grafana Loki of OpenSearch-logzoekopdrachten.
Voorbeelden omvatten API-key, Basic Auth, HMAC, cursorpaginering, rate-limitafhandeling, OAuth refresh, async jobs, incrementele cursors en CSV-, XLSX-, Parquet-, NDJSON- en veilige ZIP-inname.
Gebruik starters voor queryDataSources, multi-source joins, rowsRef,
schemavalidatie, deduplicatie, PII-redactie, datasource-appends, Parquet-exports,
RAG-lookups, goedkeuringstaken, notificaties, apps, widgets en triggers.
De catalogus bevat starters voor data, catalog, stream_data,
transformer, detection, action, app,
llm_tool, widget, trigger en server.
queryDataSources- en rowsRef-starters wanneer actuele gebruikerstoegang en forced filters behouden moeten blijven.Gebruik het veld Groep om Elements binnen je tenant visueel te ordenen. Groepen helpen beheerders om Elements sneller terug te vinden wanneer de lijst groeit.
Finance, Operations of Experimenten.Alle editorvelden, filemanageracties, validatieregels en codecontract.
Open editor reference →Publish/versioning, runtime vars/secrets, test execute payloads en logvelden.
Open runtime reference →Per helper: signature, payload format, return shape, voorbeeldcode en scope-notities.
Open builtin contracts →element om een element als querybare bron te draaien.kind="catalog" en datasource type catalog om één externe verbinding via getSchemas, getTables, getColumns en runQuery voor meerdere tabellen te hergebruiken.elementParams en request param mapping voor dynamische input.kind="llm_tool" wanneer een gepubliceerd Element als tenant-scoped dynamic tool beschikbaar moet zijn voor Dashbot of dashview-llm.dashview-llm → llm-tool-executor → dashview-be → elements-runner.rowsRef-retrieval en downstream calls mogen forced filters of gebruikersrechten niet omzeilen.def run(params):.element en kies het gepubliceerde Element.elementParams, bijvoorbeeld een default country of limit.livestream-Element-datasources en voor parquet-snapshot wanneer Snapshot bij elk verzoek is gekozen.allowedRequestParams / Toegestane doorgestuurde filtersleutels om expliciet te bepalen welke filterkeys naar het Element mogen.requestParamMap als de dashboardfilterkey anders heet dan de param die je Element verwacht.params, bijvoorbeeld params.get("country").def run(params):
country = params.get("country", "NL")
limit = int(params.get("limit", 10))
rows = load_sales_rows(country=country, limit=limit)
return [{
"country": row["country"],
"customer": row["customer"],
"revenue": row["revenue"],
} for row in rows]
Voorbeeldflow: dashboardfilter country → Element-datasource request param
country → params.get("country") in het Element → widget rendert de nieuwe rows.
queryDataSources, query_datasources, dataSources.query of dataSources.query_rows aan.sources mee. Een source kan een datasource-ID zijn of een volledige source spec zoals {"type":"datasource","dataSourceId":"orders-ds","alias":"orders"}.alias wanneer die is meegegeven, anders uit de DuckDB-veilige datasource-ID/tabelnaam die de worker exposeert.def run():
sources = [{
"alias": "orders",
"type": "datasource",
"dataSourceId": "orders-ds",
}]
result = queryDataSources("""
SELECT customer, SUM(revenue) AS revenue
FROM orders
GROUP BY customer
ORDER BY revenue DESC
LIMIT 100
""", sources=sources, maxRows=100)
return result.rows
Voor grotere chained reads of datapreparatie geef je asTable, table of tableName mee.
De parent worker schrijft het geneste resultaat naar een parquet sidecar en de Element-runtime laadt het in de request-local
DuckDB connection. Het helperresultaat heeft table, rowCount, columns,
metadata en lege rows.
def run(duckdb):
    queryDataSources(
        "SELECT customer, revenue FROM orders",
        sources=[{
            "alias": "orders",
            "type": "datasource",
            "dataSourceId": "orders-ds",
        }],
        asTable="orders_local",
    )
    duckdb.execute("""
        CREATE TABLE output AS
        SELECT customer, revenue * 1.21 AS revenue_with_tax
        FROM orders_local
    """)
    return {"table": "output"}
Tenant-scoped GCS helpers kun je combineren met de lokale DuckDB connection. Download het bestand naar
workspace, lees het met DuckDB, draai SQL-wijzigingen zoals UPDATE, exporteer een vervangend
bestand en upload het terug naar hetzelfde tenant-scoped pad met overwrite=True.
import base64
from pathlib import Path

def run(duckdb, workspace):
    object_path = "datasets/orders.parquet"
    work = Path(workspace)
    input_path = work / "orders.parquet"
    output_path = work / "orders.updated.parquet"

    downloaded = downloadGcsFile(object_path, asBytes=True)
    input_path.write_bytes(base64.b64decode(downloaded["dataBase64"]))

    duckdb.execute(
        "CREATE TABLE orders AS SELECT * FROM read_parquet(?)",
        [str(input_path)]
    )
    duckdb.execute("""
        UPDATE orders
        SET status = 'archived'
        WHERE status = 'closed'
    """)
    duckdb.execute("COPY orders TO ? (FORMAT PARQUET)", [str(output_path)])

    return uploadGcsFile(
        object_path,
        dataBase64=base64.b64encode(output_path.read_bytes()).decode("ascii"),
        contentType="application/vnd.apache.parquet",
        overwrite=True,
    )
Terugschrijven naar hetzelfde pad vervangt het object. Gebruik een nieuw outputpad wanneer je review of bestandsversies voor vervanging nodig hebt.
Gebruik appendDataSourceRows of dataSources.appendRows wanneer een Element JSON rows moet appenden naar een uplink/parquet-backed datasource.
De write wordt gecontroleerd tegen de effectieve request access context voordat de worker hem naar uplink stuurt.
def run():
    result = appendDataSourceRows(
        "element-events",
        [{"event": "refresh_complete", "count": 42}],
        merge=True,
        meta={"source": "element"},
    )
return {"inserted": result["inserted"]}rows, columns, rowCount, .to_pandas() en .to_dataframe().maxRows geldt nog steeds voor geneste reads, inclusief asTable-materialisatie.rowsRef, inline of file source specs wanneer je worker-produced artifacts via de helper chaint.return: standaard outputreturn rows voor normale Elements, Element-datasources en kleine tot middelgrote snapshots.{"table": "output"}.{"rows": rows, "meta": ...} als de downstream datasource een pure rows-array verwacht.yield: rows stuk voor stuk producerenyield row wanneer je rows kunt produceren zonder eerst alles in een lijst te verzamelen.yield en return rows; kies één outputmodus.rows = list(iterator) als de bron groot kan worden. Je laadt dan de volledige dataset in het geheugen van de Element-runtime.yield daarna de outputrow.queryDataSources(..., maxRows=...) of datasourcefilters om de input bewust te begrenzen wanneer je alleen een sample of top-N nodig hebt..to_pandas() alleen als je echt een DataFrame nodig hebt; die stap materialiseert alle opgehaalde rows opnieuw in memory.appendRows, replaceRows en emitProgress; yield is voor het eindresultaat van de entrypoint, niet voor progress-events.def run(params):
# Minder goed: alle rows eerst in memory verzamelen.
rows = list(load_external_rows(params))
return [normalize(row) for row in rows]def run(params):
# Beter voor grote bronnen: per row verwerken.
for row in load_external_rows(params):
yield normalize(row)run(params)def run(params):
limit = int(params.get("limit", 5))
country = params.get("country", "NL")
rows = []
for i in range(limit):
rows.append({
"rank": i + 1,
"country": country,
"value": (i + 1) * 100
})
return rowsdef run(params):
label = params.get("label", "demo")
multiplier = int(params.get("multiplier", 2))
values = params.get("values") or [1, 2, 3]
return [{
"label": label,
"value": value,
"score": value * multiplier
} for value in values]def run(params):
cursor = int(getVar("sync_cursor", 0) or 0)
batch_size = int(params.get("batchSize", 3))
rows = []
for index in range(batch_size):
rows.append({"cursor": cursor + index, "source": "element"})
setVar("sync_cursor", cursor + batch_size)
return rowsInteractieve Elements kunnen een tabs-node retourneren met panelcontainers als children. Elk panel heeft een id, label, optioneel icon en gewone childnodes. Zet value op het eerste actieve panel-ID. Stuur alle toegestane panelinhoud in dezelfde response mee.
Wisselen tussen tabs gebeurt lokaal en bewaart nog niet opgeslagen formulierwaarden. Knoppen en formulieracties roepen het Element nog steeds aan. Een nieuwe uitvoering zet tabs en formulieren op de geretourneerde waarden. Verborgen tabs zijn geen toegangscontrole: autoriseer de inhoud van elk panel voordat deze wordt teruggestuurd.