Patroon A: standaard dashboardbron
Maak eerst een datasource, refresh het schema, stel kolommetadata in en gebruik die bron daarna direct in widgets en filters.
Keuzehulp
Deze pagina is de brug tussen de datasource-documentatie en de element-documentatie. Gebruik haar als snelle besliswijzer wanneer je weet dat je iets met data wilt doen, maar nog niet zeker weet of dat in een connector, custom SQL, een Element-widget of een automationstap thuishoort.
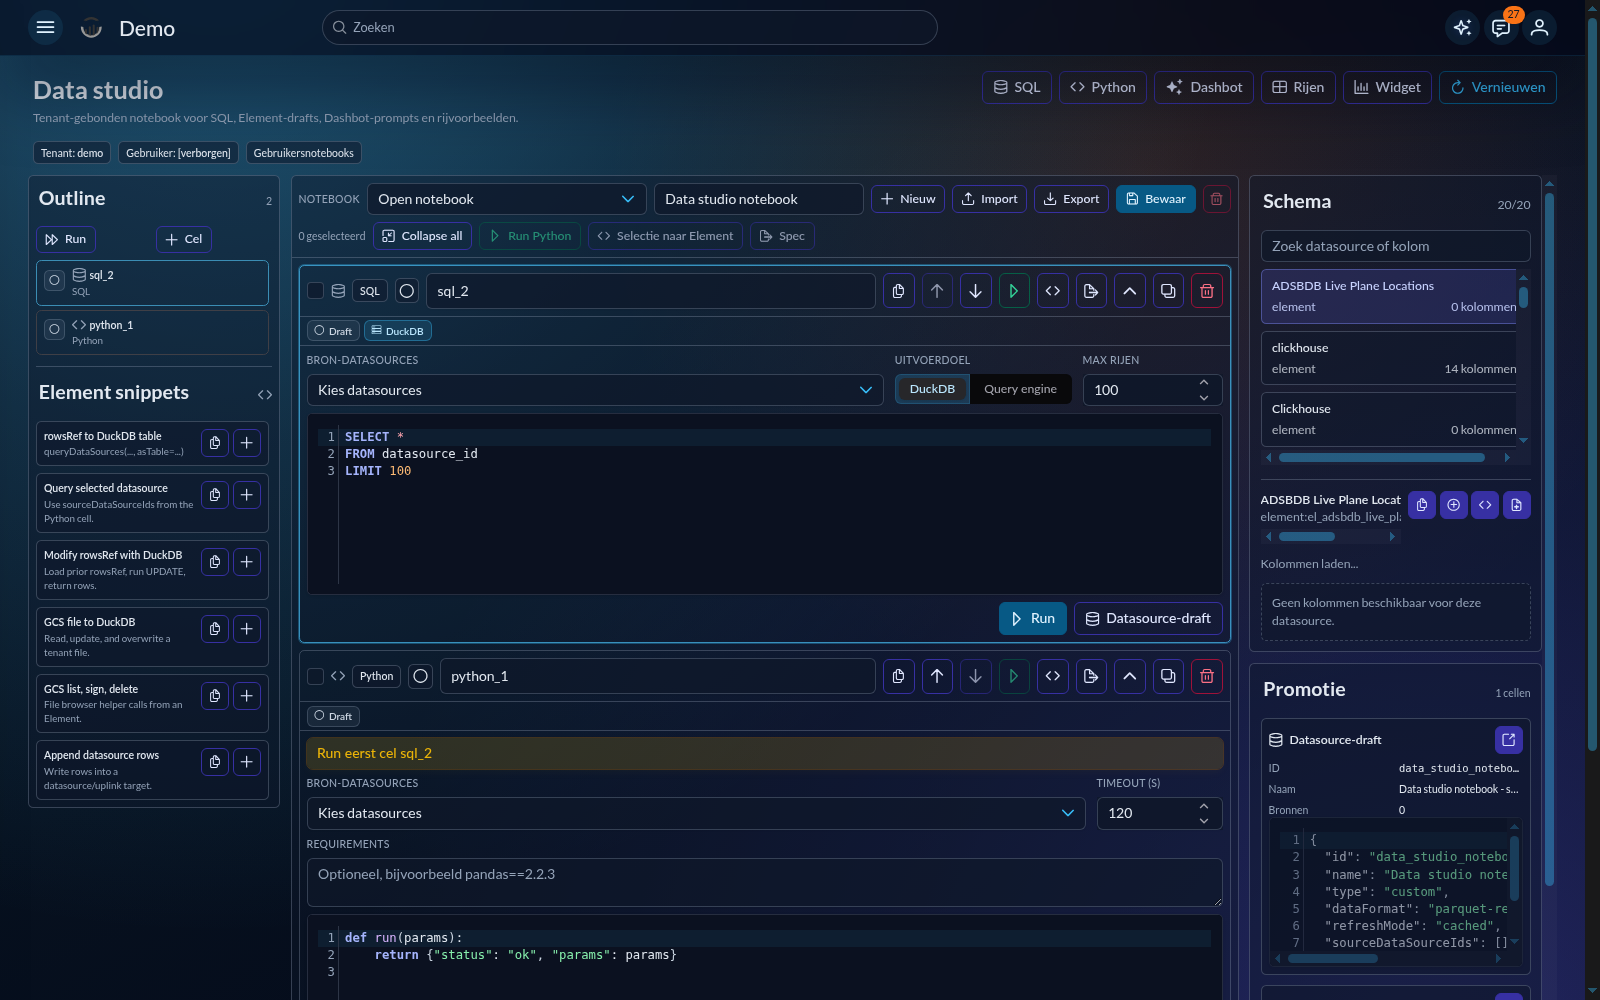
Het belangrijkste onderscheid is eenvoudig: een datasource haalt of modelleert data op tenantniveau; een Element voert Python-logica uit. In de praktijk combineer je ze vaak.
| Je doel | Beste startpunt | Waarom |
|---|---|---|
| Rijen ophalen uit een database, API of bestand | Datasource | Connectors zijn bedoeld voor stabiele data-ingang, schema-refresh en hergebruik in widgets, Dashbot en Autoflow. |
| Een eindige gepubliceerde Python-bron direct in dashboards gebruiken | Element van type data | Gepubliceerde data-Elements verschijnen direct als datasource in widgets, filters en query console. Een stream_data-Element vereist een expliciete livestream-datasource. |
| Veel tabellen via één database- of API-integratie aanbieden | Catalogus-Element | Eén gepubliceerd catalog-Element ontdekt schema's, tabellen en kolommen en voert queries voor de geselecteerde tabel uit. |
| Bestaande datasources joinen, mergen of omvormen met SQL | Custom datasource | Je publiceert één tenantbrede bron met een read-only SQL-query boven expliciet geselecteerde onderliggende datasources. |
| Data verrijken of opschonen met Python | Element met datasource helpers | Je leest expliciete bronnen via data-worker-agent en retourneert of bewaart het opgeschoonde resultaat bewust. |
| Een volledig nieuwe widget uit Python teruggeven | Element widget | Geschikt voor dynamische visualisatie of samengestelde output die niet goed past in standaard widgetopties. |
| Herbruikbare runtime-logica bouwen voor meerdere plekken | Element | Elements kun je publiceren, testen en later inzetten in datasources, widgets en automations. |
| Een terugkerende operationele flow bouwen | Autoflow | Autoflow orkestreert datasources, Elements, Dashbot en acties in één uitvoerbare workflow. |
Maak eerst een datasource, refresh het schema, stel kolommetadata in en gebruik die bron daarna direct in widgets en filters.
Publiceer een eindig Element van type data en gebruik het daarna direct als datasource in dashboards zonder extra datasource-doc. Maak voor stream_data een expliciete Element-datasource met dataFormat="livestream".
Maak een SQL-query boven geselecteerde dependency-datasources wanneer je vooral joins, filters, casts, unions of aggregaties nodig hebt en die als één herbruikbare bron wilt publiceren. Gebruik de inline query-preview tijdens het bewerken om de query met dezelfde geselecteerde bronnen via data-worker-agent uit te voeren.
Gebruik een Element wanneer Python nodig is voor businesslogica, mapping of verrijking. Lees expliciete datasources met de worker helpers en retourneer rows, schrijf een file of append naar een uplink/parquet-backed datasource.
Laat een Element een complete widgetconfig retourneren wanneer de visualisatie zelf dynamisch of conditioneel is.
Autoflow haalt data uit een datasource, laat een Element of Dashbot die interpreteren en stuurt daarna notificaties of taken.
Gebruik kind="catalog" wanneer één externe verbinding, bijvoorbeeld MySQL, meerdere
schema's en tabellen moet aanbieden. Publiceer het Element één keer. Kies daarna bij een datasource
van type catalog het Element, de versie, het ontdekte schema en de ontdekte tabel. Je hoeft
dus geen apart Element per tabel te onderhouden; meerdere datasourcebindings kunnen hetzelfde Element hergebruiken.
getSchemas(params) retourneert schemanamen of objecten met minimaal name.getTables(params) leest params["schema"] en retourneert de tabellen.getColumns(params) leest schema en tabel uit params en retourneert kolommen met name en optioneel type, label, nullable en description.runQuery(params) leest schema, table en filters uit params en retourneert rows of een ondersteund parquet/rowsRef-resultaat.@entrypoint. Zodra je decorators gebruikt, zijn alleen gedeclareerde functies uitvoerbaar.
Dashboardfilters en ondersteunde filters uit Data Studio-SQL gebruiken hetzelfde platte
params-contract voor runQuery, zodat de provider minder data hoeft op te halen.
Data-worker-agent parseert SQL met SQLGlot en zet alleen veilige, ondubbelzinnige predicates om:
gelijkheid, IN en ISO-datumbereiken via <kolom>From en
<kolom>To. Expliciete dashboard/request-params hebben voorrang wanneer dezelfde sleutel
al bestaat. Het Element ontvangt nooit de ruwe SQL-string.
Voor een eenvoudige positieve semi-join zoals
SELECT * FROM a WHERE b IN (SELECT d FROM c) materialiseert Dashview eerst bron
c. Pas nadat toegang, forced filters en kolomrechten op die bron zijn toegepast, worden
maximaal 1.000 verschillende niet-lege waarden van d als lijstparameter b naar
Elementbron a gestuurd. De totale lijst is bovendien begrensd op 64 KiB.
Dit is alleen query-pushdown. Predicates die niet veilig aan precies één bron kunnen worden gekoppeld,
blijven lokaal in de volledige DuckDB-query staan. Dat geldt ook voor lege of te grote semi-joinlijsten,
NOT IN, gecorreleerde subqueries en subqueries met filters, aggregaties of limieten. Nadat
het Elementresultaat is gematerialiseerd, past Dashview opnieuw datasource-toegang, forced row filters
en de toegestane kolommen van de huidige gebruiker toe voordat rows of parquet worden teruggegeven.
Gebruik een read-only databaseaccount, bewaar credentials in de runtime secret store en accepteer alleen schema-, tabel- en kolomnamen die het Element zelf heeft ontdekt. Behandel alle ontvangen filterwaarden als onbetrouwbare input en bind identifiers en waarden als parameters in de providerquery. Voeg nooit vrije gebruikersinvoer rechtstreeks samen tot SQL.
@entrypoint
def getSchemas(params=None):
    return [{"name": "sales"}]

@entrypoint
def getTables(params=None):
    return [{"name": "orders", "schema": params["schema"]}]

@entrypoint
def getColumns(params=None):
    return [{"name": "order_id", "type": "BIGINT", "nullable": False}]

@entrypoint
def runQuery(params=None):
    # Valideer schema/table tegen provider-metadata en voer een begrensde read-only query uit.
return [{"order_id": 42, "tenant_id": "tenant-a"}]data-Element volstaat, of dat je een expliciete datasource nodig hebt voor scheduling, parquet of extra connectorinstellingen. Gebruik voor meerdere externe tabellen één catalog-Element met afzonderlijke schema/tabel-bindings. Een stream_data-Element heeft altijd een expliciete livestream-datasource nodig.catalog-Element voor een externe catalogus met meerdere tabellen, gebruik eindige gepubliceerde data-Elements direct wanneer geen extra configuratie nodig is en plaats stream_data-Elements altijd achter een expliciete livestream-datasource.